مدلهای زبانی بزرگ (LLM) امروزه به بخش مهمی از ابزارهای هوش مصنوعی تبدیل شدهاند و جتی در چتباتها، دستیارهای برنامهنویسی، سامانههای پشتیبانی مشتریان و تحلیل اطلاعات سازمانی استفاده میشوند. بااینحال، اتصال این مدلها به دادههای حساس و سیستمهای عملیاتی، تهدیدات امنیتی جدیدی ایجاد کرده است که مقابله با آنها به روشهایی فراتر از امنیت نرمافزارهای سنتی نیاز دارد.
امنیت مدلهای زبانی بزرگ یا LLM Security مجموعهای از روشها و کنترلهای امنیتی است که از مدلهای زبانی، دادههای مورد استفاده، زیرساختهای اجرایی و برنامههای متصل به آنها در برابر دسترسی غیرمجاز، دستکاری، نشت اطلاعات و سوءاستفاده محافظت میکند. این حوزه از امنیت سایبری، تمام مراحل توسعه، آموزش، استقرار و استفاده از مدلهای زبانی را در بر میگیرد.
در این مقاله، مهمترین آسیبپذیریهای امنیتی LLM بر اساس چارچوب OWASP در سال ۲۰۲۶، خطرات استفاده سازمانی از مدلهای زبانی و روشهای عملی برای محافظت از آنها را بررسی میکنیم.
امنیت مدلهای زبانی بزرگ (LLM Security) چیست؟
امنیت مدلهای زبانی بزرگ (Large Language Model Security) به مجموعه اقدامات فنی، مدیریتی و عملیاتی گفته میشود که با هدف حفاظت از مدلهای زبانی و برنامههای مبتنی بر آنها در برابر تهدیدات سایبری انجام میشوند.
مدلهای زبانی مانند مدلهای مورد استفاده در ChatGPT، Gemini و سایر دستیارهای هوشمند، با پردازش حجم زیادی از دادهها میتوانند متن تولید کنند، اطلاعات را خلاصه کنند، به پرسشها پاسخ دهند و در انجام فعالیتهای مختلف به کاربران کمک کنند. اما همین قابلیتها زمانی که به اطلاعات محرمانه یا ابزارهای سازمانی متصل شوند، میتوانند سطح حمله جدیدی ایجاد کنند.
برای مثال، یک شرکت ممکن است از یک مدل زبانی برای پاسخگویی به سؤالات کارکنان درباره اسناد داخلی استفاده کند. در چنین سیستمی، حفاظت از مدل بهتنهایی کافی نیست؛ بلکه باید مشخص شود چه کسی به اطلاعات دسترسی دارد، چه دادههایی به مدل ارسال میشوند، مدل اجازه انجام چه اقداماتی را دارد و خروجی آن چگونه بررسی میشود.
بنابراین امنیت LLM صرفاً به جلوگیری از تولید پاسخهای نامناسب محدود نیست، بلکه شامل حفاظت از محرمانگی دادهها، یکپارچگی اطلاعات، دسترسپذیری خدمات و جلوگیری از اقدامات غیرمجاز نیز میشود.
این موضوع زیرمجموعهای از امنیت هوش مصنوعی است؛ حوزهای گستردهتر که حفاظت از انواع سیستمهای مبتنی بر هوش مصنوعی، از مدلهای زبانی گرفته تا سامانههای بینایی ماشین و مدلهای پیشبینی را شامل میشود.
چرا امنیت مدلهای زبانی در سال ۲۰۲۶ اهمیت بیشتری پیدا کرده است؟
اهمیت امنیت مدلهای زبانی با افزایش نقش آنها در فرایندهای سازمانی بیشتر شده است. بسیاری از سیستمهای هوش مصنوعی دیگر تنها یک ابزار تولید متن نیستند، بلکه به اطلاعات داخلی، سرویسهای ابری، پایگاههای داده و نرمافزارهای عملیاتی متصل میشوند.
در یک چتبات ساده، خطای مدل ممکن است به ارائه پاسخ نادرست محدود شود؛ اما اگر همان مدل به سامانه مدیریت مشتریان یا ابزار ارسال ایمیل دسترسی داشته باشد، یک دستور اشتباه یا دستکاریشده میتواند پیامدهای جدیتری ایجاد کند.
از سوی دیگر، استفاده گسترده از مدلهای آماده، سرویسهای شخص ثالث و پروژههای متنباز باعث شده است سازمانها همیشه کنترل کاملی بر تمام اجزای زنجیره تأمین هوش مصنوعی نداشته باشند. چنین شرایطی، بررسی امنیت مدل، اعتبار منابع و نحوه مدیریت دادهها را ضروری میکند.
در نسخه ۲۰۲۶ فهرست OWASP Top 10 for LLM Applications، تهدیداتی مانند تزریق پرامپت، افشای اطلاعات حساس، اختیارات بیشازحد عاملهای هوشمند، مسمومسازی داده و مدل و ضعفهای مربوط به بردارها و Embeddingها بهعنوان ریسکهای مهم برنامههای مبتنی بر LLM معرفی شدهاند. این تهدیدات نشان میدهند که امنیت مدلهای زبانی باید از همان مراحل طراحی و توسعه در نظر گرفته شود و به بررسی خروجی چتبات پس از انتشار محدود نباشد.
مدلهای زبانی بزرگ چگونه مورد حمله قرار میگیرند؟
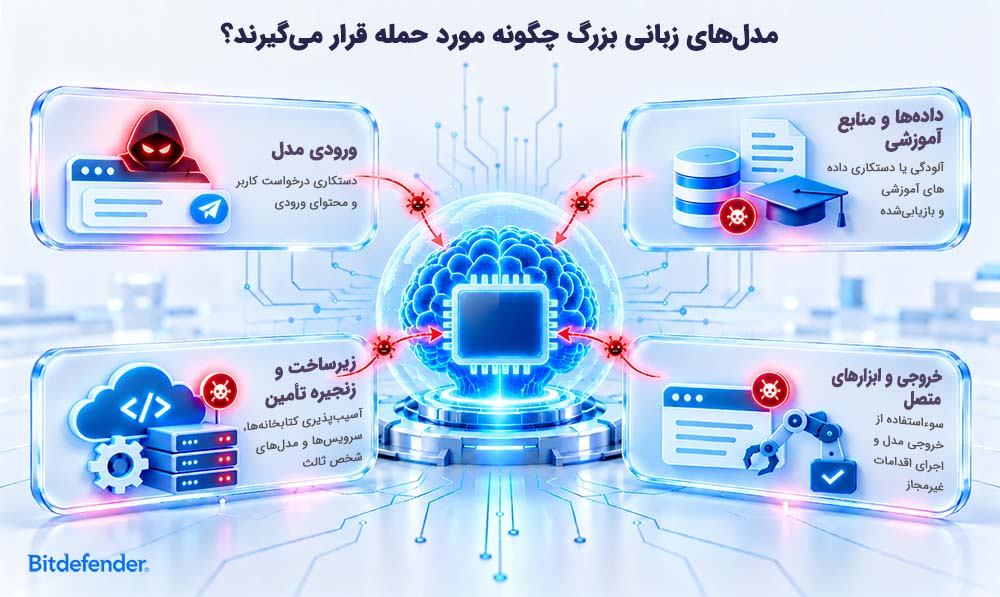
برای درک آسیبپذیریهای LLM، ابتدا باید مسیر پردازش اطلاعات در این سیستمها را بشناسیم. یک برنامه مبتنی بر مدل زبانی معمولاً درخواست کاربر را دریافت میکند، در صورت نیاز اطلاعات مرتبط را از منابع دیگر به دست میآورد و پس از پردازش توسط مدل، پاسخ یا اقدامی را تولید میکند. در این فرایند، چند نقطه میتوانند هدف مهاجمان قرار گیرند: ورودی کاربر، منابع داده، مدل و اجزای وابسته به آن، خروجی تولیدشده و ابزارهایی که به سیستم متصل هستند.
تهدیدات ورودی مدل
ورودی مدل ممکن است شامل درخواست کاربر، اسناد، محتوای وبسایتها یا دادههای بازیابیشده از منابع سازمانی باشد. مهاجم میتواند تلاش کند با دستکاری این اطلاعات، رفتار سیستم را تغییر دهد یا آن را از وظیفه اصلی منحرف کند.
تهدیدات دادهها و منابع آموزشی
دادههای مورد استفاده برای آموزش، تنظیم دقیق (Fine-tuning) یا بازیابی اطلاعات، نقش مهمی در عملکرد مدل دارند. تغییر عمدی این دادهها میتواند به تولید پاسخهای نادرست، ایجاد رفتارهای پنهان یا کاهش قابلیت اعتماد مدل منجر شود.
تهدیدات زیرساخت و زنجیره تأمین
مدلهای زبانی معمولاً به کتابخانهها، سرویسهای پردازشی، APIها و گاهی مدلهای آماده شخص ثالث وابستهاند. آسیبپذیری در هر یک از این اجزا ممکن است امنیت کل برنامه را تحت تأثیر قرار دهد.
تهدیدات خروجی و ابزارهای متصل
خروجی مدل همیشه نباید بهعنوان اطلاعات صحیح یا دستور قابل اجرا در نظر گرفته شود. اگر یک برنامه بدون اعتبارسنجی، خروجی مدل را وارد پایگاه داده کند یا برای اجرای عملیات حساس به کار بگیرد، ممکن است زمینه سوءاستفاده فراهم شود.
این موضوع بهویژه در عاملهای هوش مصنوعی یا AI Agents اهمیت دارد؛ زیرا این سیستمها میتوانند علاوه بر تولید پاسخ، با ابزارهای خارجی تعامل داشته باشند و اقدامات مشخصی انجام دهند.
۱۰ آسیبپذیری مهم امنیت مدلهای زبانی بر اساس OWASP در سال ۲۰۲۶
پروژه OWASP GenAI Security یکی از منابع تخصصی برای شناسایی تهدیدات امنیتی برنامههای مبتنی بر مدلهای زبانی است. فهرست OWASP Top 10 به توسعهدهندگان، کارشناسان امنیت و سازمانها کمک میکند ریسکهای مهم را شناسایی کرده و برای کاهش آنها برنامهریزی کنند.
نسخه ۲۰۲۶ این فهرست در اوت همان سال منتشر شد و نسبت به نسخه قبلی، تغییراتی در ترتیب و دستهبندی بعضی ریسکها دارد.
| شناسه | آسیبپذیری امنیتی | پیامد احتمالی |
|---|---|---|
| LLM01:2026 | Prompt Injection | تغییر غیرمجاز رفتار مدل |
| LLM02:2026 | Sensitive Information Disclosure | افشای اطلاعات حساس |
| LLM03:2026 | Excessive Agency | انجام اقدامات خارج از اختیارات موردنیاز |
| LLM04:2026 | Supply Chain | سوءاستفاده از اجزای وابسته و منابع ثالث |
| LLM05:2026 | Data and Model Poisoning | دستکاری رفتار و قابلیت اعتماد مدل |
| LLM06:2026 | Unbounded Consumption | مصرف غیرمجاز منابع و افزایش هزینه |
| LLM07:2026 | Misinformation | تولید اطلاعات نادرست و گمراهکننده |
| LLM08:2026 | Hidden Context Exposure | افشای اطلاعات موجود در زمینههای پنهان |
| LLM09:2026 | Vector and Embedding Weaknesses | دستکاری دادههای بازیابیشده یا دسترسی نامناسب |
| LLM10:2026 | Improper Output Handling | سوءاستفاده از خروجی کنترلنشده مدل |
۱. تزریق پرامپت (Prompt Injection)
تزریق پرامپت یکی از شناختهشدهترین تهدیدات مدلهای زبانی است. در این حمله، مهاجم تلاش میکند با وارد کردن دستورهای فریبنده در پیام یا دادههای دریافتی، مدل را به تغییر رفتار یا انجام کاری خارج از هدف اصلی وادار کند.
برای مثال، ممکن است یک دستیار سازمانی هنگام خلاصهسازی اسناد با متنی مواجه شود که از آن میخواهد اطلاعاتی خارج از درخواست کاربر ارائه دهد. اگر سیستم نتواند میان دستور معتبر و داده غیرقابلاعتماد تمایز برقرار کند، احتمال دستکاری پاسخ وجود دارد.
این تهدید به دو شکل اصلی مستقیم و غیرمستقیم رخ میدهد و در سیستمهای متصل به منابع خارجی اهمیت ویژهای دارد.
۲. افشای اطلاعات حساس (Sensitive Information Disclosure)
مدلهای زبانی ممکن است هنگام پردازش یا تولید پاسخ، اطلاعات محرمانهای را آشکار کنند که نباید در اختیار کاربر قرار بگیرند. این اطلاعات میتوانند شامل مشخصات مشتریان، اسناد تجاری، اطلاعات مالی، دادههای شخصی یا اطلاعات احراز هویت باشند.
برای مثال، اگر یک دستیار هوشمند به اسناد منابع انسانی دسترسی داشته باشد و کنترل مجوزها بهدرستی اعمال نشده باشد، ممکن است بخشی از اطلاعات کارکنان را در پاسخ به کاربر غیرمجاز نمایش دهد.
افشای اطلاعات همیشه نتیجه یک حمله مستقیم نیست. طراحی نامناسب برنامه، اشتباه در مدیریت دسترسی یا ارسال دادههای حساس به سرویسهایی با سیاست نگهداری نامتناسب نیز میتواند این خطر را افزایش دهد. برای کاهش این ریسک باید دسترسی به دادهها محدود شود، اطلاعات غیرضروری پیش از ارسال به مدل حذف یا پنهان شوند و خروجیهای حساس تحت کنترل قرار گیرند. این اقدامات با اصول کلی امنیت دادهها ارتباط مستقیم دارند.
۳. اختیارات بیشازحد (Excessive Agency)
این آسیبپذیری زمانی ایجاد میشود که یک برنامه مبتنی بر LLM، اختیارات یا استقلال عملیاتی بیشتری از آنچه برای انجام وظیفه ضروری است در اختیار مدل قرار دهد. فرض کنید یک عامل هوش مصنوعی برای تهیه گزارش فروش به پایگاه داده متصل شده است. این عامل برای انجام وظیفه خود به دسترسی خواندن اطلاعات نیاز دارد؛ اما اگر امکان تغییر یا حذف رکوردها را نیز داشته باشد، یک خطا یا دستور مخرب میتواند خسارت جدی ایجاد کند. اصل حداقل دسترسی (Least Privilege) یکی از مهمترین راهکارهای مقابله با این مشکل است. بر همین اساس، ابزارهای متصل به مدل باید فقط مجوزهای ضروری را داشته باشند و عملیات حساس مانند حذف اطلاعات یا ارسال داده به مقصد خارجی به کنترل مستقل وابسته باشند.
۴. آسیبپذیری زنجیره تأمین (Supply Chain)
امنیت یک مدل زبانی تنها به کد اصلی یا معماری آن وابسته نیست. کتابخانههای نرمافزاری، مدلهای آماده، مجموعه دادهها، سرویسهای ابری و افزونههای شخص ثالث نیز بخشی از زنجیره تأمین آن هستند. اگر یکی از این اجزا آلوده، دستکاریشده یا دارای آسیبپذیری باشد، ممکن است امنیت کل سیستم به خطر بیفتد.
بهعنوان مثال، استفاده از یک مدل آماده دانلودشده از منبع نامعتبر میتواند سازمان را در معرض فایلهای مخرب یا رفتارهای ناخواسته قرار دهد. این خطر بهویژه زمانی اهمیت دارد که مدل و کدهای همراه آن در زیرساخت داخلی اجرا میشوند.
برای کاهش ریسک باید منابع مدلها و کتابخانهها بررسی شوند، نسخهها تحت کنترل قرار گیرند، وابستگیها اسکن امنیتی شوند و امکان ردیابی منشأ اجزای سیستم وجود داشته باشد.
۵. مسمومسازی داده و مدل (Data and Model Poisoning)
مسمومسازی داده و مدل زمانی رخ میدهد که مهاجم تلاش کند با دستکاری دادههای آموزشی، دادههای تنظیم دقیق یا اطلاعات مرتبط با مدل، عملکرد آن را به شکل دلخواه تغییر دهد.
برای مثال، اگر دادههای مورد استفاده برای تنظیم دقیق یک مدل حاوی نمونههای مخرب باشند، ممکن است مدل در شرایط مشخص پاسخهای جهتدار یا غیرقابلاعتماد تولید کند.
این حملات میتوانند بر دقت، یکپارچگی و قابلیت اعتماد مدل تأثیر بگذارند. در بعضی سناریوها نیز ممکن است رفتارهای پنهانی ایجاد کنند که تنها در مواجهه با ورودیهای خاص فعال شوند. استفاده از دادههای معتبر، کنترل تغییرات مجموعه داده، ارزیابی کیفیت دادههای آموزشی و آزمون رفتار مدل پیش و پس از تغییرات، از اقدامات مهم برای کاهش این خطر هستند.
۶. مصرف نامحدود منابع (Unbounded Consumption)
پردازش درخواستها در مدلهای زبانی به منابع محاسباتی نیاز دارد و در بسیاری از سرویسها بر اساس میزان مصرف، هزینه ایجاد میکند. اگر محدودیت مناسبی برای تعداد درخواستها، حجم ورودی، طول خروجی یا استفاده از ابزارها تعریف نشده باشد، مهاجم یا حتی یک فرایند معیوب ممکن است باعث مصرف بیشازحد منابع شود. این مشکل میتواند به افزایش هزینه API، کاهش سرعت پاسخگویی یا اختلال در دسترسپذیری سرویس منجر شود. استفاده از محدودیت نرخ درخواست (Rate Limiting)، تعیین سقف مصرف، مدیریت بودجه پردازشی و نظارت بر الگوهای استفاده از راهکارهای اصلی مقابله با این ریسک هستند.
۷. تولید اطلاعات نادرست (Misinformation)
مدلهای زبانی ممکن است اطلاعاتی تولید کنند که ظاهری معتبر و قانعکننده دارند، اما از نظر واقعی نادرست یا فاقد پشتوانه هستند. این پدیده در برخی شرایط با اصطلاح توهم مدل یا Hallucination شناخته میشود. در محیطهای سازمانی، استفاده بدون بررسی از چنین خروجیهایی میتواند به تصمیمگیری نادرست یا ایجاد مشکلات عملیاتی منجر شود.
برای مثال، یک دستیار امنیتی ممکن است راهکاری را برای رفع آسیبپذیری پیشنهاد کند که با نسخه واقعی نرمافزار سازگار نیست. اجرای این پیشنهاد بدون اعتبارسنجی میتواند مشکلات جدیدی ایجاد کند.
اتصال پاسخها به منابع معتبر، نمایش مستندات پشتیبان، تعیین سطح اطمینان و بررسی انسانی تصمیمهای حساس، به کاهش این ریسک کمک میکنند.
۸. افشای زمینه پنهان (Hidden Context Exposure)
برنامههای مبتنی بر LLM معمولاً علاوه بر پیام قابلمشاهده کاربر، اطلاعات دیگری مانند دستورهای سیستمی، زمینه گفتگو، دادههای بازیابیشده یا نتایج ابزارها را پردازش میکنند. بعضی از این اطلاعات نباید در پاسخ نهایی آشکار شوند. اگر طراحی برنامه یا کنترلهای امنیتی مناسب نباشد، ممکن است بخشهایی از این زمینه پنهان در اختیار افراد غیرمجاز قرار بگیرد.
برای مثال، یک دستیار ممکن است اطلاعات داخلی مربوط به تنظیمات برنامه یا دادههایی را که تنها برای پردازش یک وظیفه در اختیار آن قرار گرفتهاند، در پاسخ خود بازگو کند.
راهکار اصلی، قرار ندادن اسرار و اطلاعات حساس غیرضروری در زمینه مدل، کنترل دسترسی مستقل و جلوگیری از استفاده از دستورهای سیستمی بهعنوان محل نگهداری اطلاعات محرمانه است.
۹. ضعفهای بردارها و Embeddingها (Vector and Embedding Weaknesses)
بسیاری از سیستمهای مبتنی بر مدلهای زبانی برای جستجو در اسناد و بازیابی اطلاعات از Embedding و پایگاههای داده برداری استفاده میکنند. Embedding نوعی نمایش عددی اطلاعات است که به سیستم کمک میکند محتوای مرتبط با یک پرسش را پیدا کند. این فناوری در معماری RAG کاربرد گستردهای دارد. اگر دادههای ذخیرهشده در پایگاه برداری دستکاری شوند یا محدودیت دسترسی به اسناد بهدرستی اعمال نشود، ممکن است سیستم اطلاعات نامعتبر یا محرمانه را بازیابی کند.
برای نمونه، در یک سامانه جستجوی داخلی، کارمند بخش فروش نباید بتواند صرفاً از طریق پرسیدن سؤال از دستیار، اسناد محرمانه منابع انسانی را دریافت کند.
بنابراین کنترل دسترسی باید هنگام بازیابی اطلاعات و پیش از ارسال آنها به مدل اجرا شود؛ نه اینکه صرفاً از مدل خواسته شود اطلاعات محرمانه را نمایش ندهد.
۱۰. مدیریت نامناسب خروجی مدل (Improper Output Handling)
خروجی مدل زبانی نباید بدون بررسی بهعنوان ورودی معتبر برای بخشهای دیگر نرمافزار استفاده شود.
برای مثال، اگر یک برنامه محتوای تولیدشده توسط مدل را مستقیماً در یک صفحه وب نمایش دهد، بدون آنکه کاراکترها و ساختار خروجی بهدرستی پردازش شده باشند، ممکن است زمینه آسیبپذیریهایی مانند Cross-Site Scripting فراهم شود.
همچنین استفاده مستقیم از خروجی مدل برای ساخت دستورات پایگاه داده یا اجرای فرمانهای سیستم میتواند خطرآفرین باشد. راهکار مناسب شامل اعتبارسنجی ساختار خروجی، استفاده از APIهای امن، پردازش صحیح دادهها و جلوگیری از اجرای مستقیم خروجی مدل بهعنوان کد یا فرمان است.
تفاوت LLM Security و AI Security چیست؟
امنیت هوش مصنوعی (AI Security) حوزهای گسترده است که حفاظت از انواع سامانههای هوش مصنوعی، دادهها، الگوریتمها و زیرساختهای مرتبط با آنها را در بر میگیرد. در مقابل، LLM Security بهصورت تخصصی بر مدلهای زبانی بزرگ و برنامههایی تمرکز دارد که از این مدلها استفاده میکنند.
برای مثال، محافظت از یک مدل تشخیص تصویر در برابر دادههای دستکاریشده میتواند در حوزه AI Security قرار بگیرد؛ اما جلوگیری از افشای اطلاعات در یک چتبات مبتنی بر مدل زبانی، موضوعی مشخص در LLM Security است.
| معیار | AI Security | LLM Security |
|---|---|---|
| دامنه | انواع سیستمهای هوش مصنوعی | مدلهای زبانی بزرگ و برنامههای مرتبط |
| نمونه سیستم | بینایی ماشین، مدلهای پیشبینی، LLM | چتبات، دستیار متنی، سامانه RAG |
| تهدیدات | حملات خصمانه، دستکاری داده و مدل، سوءاستفاده از زیرساخت | Prompt Injection، نشت زمینه، سوءاستفاده از ابزارها و سایر ریسکهای LLM |
| کنترلهای امنیتی | مدیریت ریسک، امنیت داده، مدل و زیرساخت | کنترل ورودی و خروجی، مجوزدهی، امنیت ابزارها و دادههای بازیابیشده |
| هدف | حفاظت از سامانههای AI | حفاظت تخصصی از مدلها و برنامههای مبتنی بر LLM |
در واقع LLM Security بخشی از AI Security است، نه یک حوزه کاملاً جداگانه. به همین دلیل، سازمانهایی که از مدلهای زبانی استفاده میکنند باید هم الزامات عمومی امنیت هوش مصنوعی و هم تهدیدات اختصاصی LLM را در نظر بگیرند.
امنیت مدلهای زبانی در معماری RAG
یکی از روشهای رایج برای استفاده سازمانی از مدلهای زبانی، معماری Retrieval-Augmented Generation یا RAG است. در این روش، مدل بهجای اتکا به اطلاعات آموختهشده در زمان آموزش، محتوای مرتبط با درخواست کاربر را از منابع مشخص بازیابی کرده و از آن برای تولید پاسخ استفاده میکند.
برای مثال، یک شرکت میتواند اسناد راهنمای محصولات خود را در پایگاه دانش قرار دهد و با استفاده از RAG، دستیار هوشمندی ایجاد کند که به سؤالات مشتریان بر اساس اطلاعات همان اسناد پاسخ دهد.
هرچند این معماری میتواند کیفیت پاسخها را بهبود دهد، اما بهصورت خودکار امنیت اطلاعات را تضمین نمیکند.
مهمترین خطرات امنیتی RAG
- خطر نخست، بازیابی اسناد غیرمجاز است. اگر کنترل دسترسی در مرحله جستجو اعمال نشود، ممکن است اطلاعات محرمانه کاربران دیگر وارد زمینه مدل شود.
- خطر دوم، دستکاری منابع است. اگر مهاجم بتواند محتوای یک سند یا پایگاه دانش را تغییر دهد، ممکن است پاسخهای مدل را تحت تأثیر قرار دهد.
- خطر سوم، ورود دستورهای مخرب از طریق دادههای بازیابیشده است. این اتفاق میتواند زمینهساز حملات غیرمستقیم Prompt Injection شود.
چگونه امنیت RAG را افزایش دهیم؟
برای محافظت از سیستمهای RAG باید مجوز دسترسی به اسناد پیش از بازیابی بررسی شود، منابع اطلاعاتی اعتبارسنجی شوند و تغییرات پایگاه دانش قابل ردیابی باشند. همچنین اطلاعات بازیابیشده باید بهعنوان داده غیرقابلاعتماد پردازش شوند و مدل نباید صرفاً بر اساس محتوای یک سند، مجوز انجام عملیات حساس را دریافت کند. استفاده از ثبت رویدادهای بازیابی، محدودسازی دادههای قابلدسترسی و بررسی کیفیت منابع نیز به کاهش خطر کمک میکند.
خطرات امنیتی اتصال LLM به ابزارها و APIها
مدلهای زبانی زمانی که به ابزارهای خارجی متصل میشوند، قابلیت انجام وظایف پیچیدهتری پیدا میکنند. برای مثال، یک دستیار میتواند از طریق API به سامانه ثبت سفارش متصل شود، اطلاعات مشتریان را بازیابی کند یا گزارش ایجاد کند. بااینحال، اتصال مدل به ابزارهای اجرایی باعث میشود امنیت سیستم تنها به پاسخ تولیدشده وابسته نباشد. در چنین شرایطی، یک درخواست اشتباه یا دستور دستکاریشده ممکن است به اجرای عملیاتی واقعی منجر شود. برای کاهش خطر، باید میان توانایی پیشنهاد یک اقدام توسط مدل و مجوز اجرای آن تفاوت قائل شد. مدل میتواند درخواست ارسال ایمیل یا تغییر یک رکورد را تولید کند، اما تصمیم نهایی درباره مجاز بودن عملیات باید توسط سیستم کنترل دسترسی و منطق برنامه گرفته شود. در عملیات حساس، استفاده از تأیید انسانی، محدودسازی ابزارها، ثبت رویدادها و بررسی مقصد انتقال داده میتواند امنیت را افزایش دهد.
روشهای محافظت و ایمنسازی مدلهای زبانی بزرگ
امنیت مدلهای زبانی با استفاده از یک ابزار یا تنظیم ساده تأمین نمیشود. رویکرد مناسب، اجرای کنترلهای امنیتی در تمام چرخه عمر سیستم و استفاده از دفاع چندلایه است.
۱. ارزیابی امنیت پیش از انتخاب مدل
پیش از استفاده از یک مدل زبانی، سازمان باید مشخص کند مدل توسط چه ارائهدهندهای عرضه میشود، دادهها چگونه پردازش میشوند و چه سیاستهایی برای نگهداری و استفاده از اطلاعات وجود دارد. در مدلهای آماده و متنباز، اعتبار منبع، نوع مجوز، وابستگیهای نرمافزاری و شیوه انتشار نسخهها نیز باید بررسی شود.
۲. حفاظت از دادههای ورودی
نباید اطلاعات حساس بدون ضرورت به مدل ارسال شوند. در مواردی که پردازش دادههای محرمانه اجتنابناپذیر است، میتوان از حذف دادههای غیرضروری، ناشناسسازی، پنهانسازی اطلاعات و محدودسازی دسترسی استفاده کرد. همچنین لازم است مشخص شود دادههای ارسالشده به سرویسهای خارجی چگونه ذخیره میشوند و آیا مطابق قرارداد، برای بهبود یا آموزش مدلها استفاده خواهند شد یا خیر.
۳. احراز هویت و کنترل دسترسی
هر کاربر یا سرویس باید فقط به اطلاعات و قابلیتهای موردنیاز خود دسترسی داشته باشد. استفاده از احراز هویت مناسب، کنترل دسترسی مبتنی بر نقش و مدیریت دقیق حسابهای سرویس، خطر سوءاستفاده را کاهش میدهد. در برنامههایی که به دادههای حساس متصل هستند، احراز هویت چندعاملی نیز میتواند بخشی از معماری دفاعی باشد.
۴. اعتبارسنجی ورودی و خروجی
ورودیهای دریافتشده از منابع خارجی باید بررسی شوند و خروجی مدل نیز پیش از استفاده در عملیات حساس اعتبارسنجی شود.
برای مثال، اگر مدل قرار است اطلاعاتی را در قالب JSON تولید کند، برنامه باید ساختار، نوع داده و مجاز بودن مقادیر را مستقل از مدل بررسی کند.
این کنترلها به کاهش برخی خطرات کمک میکنند، اما بهتنهایی تمام حملات علیه LLM را متوقف نمیکنند.
۵. محدودسازی دسترسی ابزارهای متصل
هر ابزار متصل به مدل باید تنها عملیات ضروری را ارائه دهد. دسترسی خواندن و نوشتن اطلاعات بهتر است از یکدیگر جدا باشند و عملیات حساس تحت کنترل مستقل قرار بگیرند. برای نمونه، یک دستیار تحلیل فروش معمولاً به امکان حذف اطلاعات مشتریان نیاز ندارد. حذف چنین اختیاراتی میتواند پیامد خطا یا سوءاستفاده احتمالی را کاهش دهد.
۶. ثبت رویدادها و نظارت امنیتی
فعالیتهای مهم سیستم، از جمله فراخوانی ابزارها، خطاهای دسترسی و الگوهای غیرعادی مصرف باید ثبت و بررسی شوند. البته ثبت رویداد نیز باید مطابق الزامات حریم خصوصی انجام شود و از ذخیره غیرضروری اطلاعات محرمانه کاربران جلوگیری کند.
۷. آزمون امنیتی و Red Teaming
سازمانها باید سیستمهای LLM را پیش از استقرار و پس از تغییرات مهم ارزیابی کنند. این آزمونها میتوانند شامل بررسی دسترسی غیرمجاز، تلاش برای دستکاری ورودی، نشت اطلاعات و سوءاستفاده از ابزارهای متصل باشند. آزمون امنیتی باید معماری واقعی برنامه را پوشش دهد؛ زیرا ارزیابی یک مدل بهصورت مستقل لزوماً نشاندهنده امنیت تمام اجزای محصول نهایی نیست.
امنیت مدلهای زبانی در تمام مراحل چرخه عمر
برای دستیابی به امنیت پایدار، کنترلهای لازم باید از مرحله انتخاب مدل آغاز شوند و تا پایان دوره استفاده ادامه پیدا کنند.
| مرحله | مهمترین ریسک | کنترل پیشنهادی |
|---|---|---|
| انتخاب مدل | استفاده از مدل یا منبع نامعتبر | ارزیابی تأمینکننده و منشأ مدل |
| جمعآوری داده | ورود اطلاعات حساس یا آلوده | کنترل کیفیت و طبقهبندی دادهها |
| آموزش و تنظیم دقیق | مسمومسازی داده و مدل | اعتبارسنجی داده و کنترل تغییرات |
| توسعه برنامه | ضعف در کنترل دسترسی و ابزارها | توسعه امن و اعتبارسنجی مستقل |
| استقرار | پیکربندی نادرست و دسترسی غیرمجاز | سختسازی زیرساخت و مدیریت اسرار |
| بهرهبرداری | نشت اطلاعات و سوءاستفاده از قابلیتها | پایش امنیتی و محدودسازی اختیارات |
| بهروزرسانی | تغییر رفتار و ایجاد آسیبپذیری جدید | آزمون مجدد و مدیریت نسخه |
| پایان استفاده | باقی ماندن دادهها و اعتبارنامهها | حذف امن دادهها و لغو دسترسیها |
این رویکرد با اصول مدیریت ریسک چرخه عمر سیستمهای هوش مصنوعی در چارچوب NIST AI RMF همراستا است.
استانداردها و چارچوبهای امنیت مدلهای زبانی
سازمانها برای ارزیابی امنیت LLM میتوانند از چارچوبهای شناختهشده استفاده کنند. این منابع اهداف متفاوتی دارند و بهتر است بهصورت مکمل مورد استفاده قرار گیرند.
OWASP Top 10 for LLM Applications
فهرست OWASP یکی از منابع اصلی برای شناخت آسیبپذیریهای برنامههای مبتنی بر مدلهای زبانی است. نسخه ۲۰۲۶ آن ده حوزه مهم ریسک را همراه با توضیحات، سناریوها و توصیههای دفاعی معرفی میکند.
مشاهده نسخه رسمی OWASP Top 10 for LLM Applications 2026
NIST AI Risk Management Framework
چارچوب مدیریت ریسک هوش مصنوعی NIST با هدف کمک به سازمانها در شناسایی، ارزیابی و مدیریت ریسکهای مرتبط با سیستمهای AI تدوین شده است. این چارچوب از چهار عملکرد اصلی Govern، Map، Measure و Manage تشکیل میشود و موضوعاتی مانند مسئولیتپذیری، ارزیابی ریسک و نظارت مستمر را پوشش میدهد. همچنین سند NIST AI 600-1 که در سال ۲۰۲۴ منتشر شده، راهنمای تکمیلی برای مدیریت ریسک هوش مصنوعی مولد ارائه میدهد.
MITRE ATLAS
چارچوب MITRE ATLAS مجموعهای از تاکتیکها و تکنیکهای حمله به سیستمهای هوش مصنوعی را مستند میکند.
تیمهای امنیت میتوانند از این چارچوب برای تحلیل رفتار مهاجمان، طراحی سناریوهای آزمون و شناسایی کنترلهای دفاعی مناسب استفاده کنند.
نقش راهکارهای امنیت سایبری سازمانی در حفاظت از LLM
یکی از نکات مهم در معماری امنیت مدلهای زبانی، تفکیک امنیت خود مدل از امنیت زیرساختی است که مدل روی آن اجرا میشود. راهکارهایی مانند آنتیویروس سازمانی، EDR و XDR میتوانند در حفاظت از دستگاهها، سرورها و محیطهای اجرایی نقش داشته باشند. برای مثال، اگر مهاجم تلاش کند از طریق یک آسیبپذیری نرمافزاری به سرور میزبان مدل نفوذ کند، ابزارهای حفاظت از نقاط پایانی ممکن است به شناسایی یا مهار فعالیت مخرب کمک کنند. بااینحال، این راهکارها بهتنهایی برای شناسایی تمام حملات اختصاصی مدلهای زبانی، مانند تزریق پرامپت یا دستکاری معنایی پاسخها طراحی نشدهاند. در نتیجه، امنیت LLM به ترکیبی از کنترلهای اختصاصی هوش مصنوعی، حفاظت از زیرساخت، مدیریت هویت، امنیت داده و نظارت بر رفتار سیستم نیاز دارد.
این موضوع در محیطهای مبتنی بر رایانش ابری اهمیت بیشتری دارد؛ زیرا مسئولیت امنیت میان ارائهدهنده سرویس و سازمان استفادهکننده تقسیم میشود.
چکلیست امنیت مدلهای زبانی برای سازمانها
سازمانهایی که قصد توسعه یا استفاده از برنامههای مبتنی بر LLM را دارند، بهتر است پیش از استقرار به پرسشهای زیر پاسخ دهند. آیا مدل و سرویس ارائهدهنده آن از نظر امنیت و سیاست پردازش داده ارزیابی شدهاند؟ آیا مشخص است چه اطلاعاتی مجاز به ارسال به مدل هستند؟ آیا کاربران فقط به اسناد و قابلیتهای موردنیاز خود دسترسی دارند؟ آیا عملیات حساس با مجوز مستقل اجرا میشوند؟ آیا خروجی مدل پیش از ورود به بخشهای اجرایی اعتبارسنجی میشود؟ آیا محدودیت مناسبی برای مصرف منابع وجود دارد؟ آیا رخدادهای امنیتی مهم ثبت میشوند و فرایندی برای واکنش به آنها تعریف شده است؟ پاسخ به این پرسشها میتواند به شناسایی ضعفهای اولیه کمک کند، اما برای سامانههای حساس باید ارزیابی فنی، آزمون امنیتی و بررسی الزامات قانونی نیز انجام شود.
آینده امنیت مدلهای زبانی بزرگ
با افزایش استفاده از مدلهای زبانی در برنامههای سازمانی، تمرکز امنیتی از محافظت صرف از ورودی و خروجی به سمت حفاظت از کل فرایند تصمیمگیری و اجرای اقدامات حرکت میکند. یکی از مهمترین چالشها، عاملهای هوش مصنوعی هستند که میتوانند برای انجام وظایف پیچیده از چندین ابزار استفاده کنند. افزایش استقلال این سیستمها، اهمیت کنترل مجوزها، نظارت بر عملکرد و امکان توقف اقدامات غیرمجاز را بیشتر میکند. موضوع دیگر، حفاظت از دادههای سازمانی در معماریهای RAG و محیطهای ابری است. هرچه تعداد منابع متصل به مدل افزایش پیدا کند، مدیریت دسترسی و اعتبارسنجی اطلاعات اهمیت بیشتری پیدا خواهد کرد. در چنین شرایطی، سازمانها باید امنیت مدلهای زبانی را بخشی از معماری امنیت اطلاعات خود بدانند و کنترلهای مرتبط با آن را همزمان با توسعه قابلیتهای هوش مصنوعی بهروزرسانی کنند.
نتیجهگیری
امنیت مدلهای زبانی بزرگ (LLM Security) یکی از حوزههای مهم امنیت سایبری است که بر حفاظت از مدلهای زبانی، دادهها، برنامههای متصل و زیرساختهای اجرایی تمرکز دارد. با گسترش استفاده از LLM در سازمانها، تهدیداتی مانند افشای اطلاعات، تزریق پرامپت، مسمومسازی داده، سوءاستفاده از ابزارها و ضعف در کنترل دسترسی اهمیت بیشتری پیدا کردهاند.
فهرست OWASP Top 10 در سال ۲۰۲۶ نشان میدهد که برای محافظت از سیستمهای مبتنی بر مدلهای زبانی، توجه به یک آسیبپذیری خاص کافی نیست. سازمانها باید امنیت را در تمام مراحل انتخاب، توسعه، استقرار و بهرهبرداری از مدل در نظر بگیرند.
استفاده از کنترل دسترسی دقیق، حفاظت از دادهها، اعتبارسنجی ورودی و خروجی، نظارت امنیتی و آزمون مستمر میتواند خطرات را کاهش دهد. در نهایت، یک سیستم LLM زمانی قابلاعتمادتر خواهد بود که امنیت آن نه صرفاً در پاسخهای مدل، بلکه در معماری و تمام فرایندهای مرتبط با آن پیادهسازی شده باشد.
سوالات متداول درباره امنیت مدلهای زبانی بزرگ
LLM Security به مجموعه روشها و کنترلهایی گفته میشود که از مدلهای زبانی بزرگ، دادهها و برنامههای متصل به آنها در برابر نشت اطلاعات، دسترسی غیرمجاز، دستکاری و سوءاستفاده محافظت میکنند.
تهدیدات متعددی وجود دارند و میزان اهمیت هرکدام به کاربرد سیستم بستگی دارد. در فهرست OWASP سال ۲۰۲۶، تزریق پرامپت، افشای اطلاعات حساس و اختیارات بیشازحد از مهمترین دستههای ریسک معرفی شدهاند.
امنیت استفاده به نوع سرویس، تنظیمات حساب، سیاست پردازش و نگهداری دادهها و حساسیت اطلاعات بستگی دارد. پیش از ارسال اطلاعات محرمانه باید سیاستهای ارائهدهنده و الزامات امنیتی سازمان بررسی شوند.
متنباز بودن بهتنهایی به معنی امنیت بیشتر یا کمتر نیست. مدلهای متنباز میتوانند کنترل بیشتری بر محل استقرار و پردازش دادهها فراهم کنند، اما مسئولیت ایمنسازی زیرساخت، مدیریت نسخهها و بررسی آسیبپذیریها نیز بر عهده استفادهکننده خواهد بود.
آنتیویروس و راهکارهای حفاظت از نقاط پایانی میتوانند از زیرساخت اجرای مدل در برابر برخی تهدیدات محافظت کنند، اما برای مقابله با حملات اختصاصی LLM مانند Prompt Injection، به کنترلهای امنیتی دیگری نیز نیاز است.
امنیت LLM حوزه گستردهتری است که مدل، داده، برنامه و زیرساخت را پوشش میدهد. امنیت RAG بر حفاظت از فرایند بازیابی اطلاعات، منابع داده، پایگاههای برداری و نحوه استفاده مدل از محتوای بازیابیشده تمرکز دارد.
روش واحدی وجود ندارد که تمام تهدیدات را برطرف کند. استفاده از دفاع چندلایه شامل کنترل دسترسی، حفاظت از دادهها، اعتبارسنجی ورودی و خروجی، محدودسازی ابزارها و آزمون امنیتی مستمر، رویکرد مناسبتری است.