هوش مصنوعی از یک ابزار آزمایشی به بخشی از گردش کار سازمانها تبدیل شده است؛ از پاسخگویی به مشتری و تحلیل اسناد گرفته تا تولید کد و کمک به تیمهای امنیتی. اما همان سامانهای که کارها را سریعتر میکند، ممکن است به اطلاعات محرمانه دسترسی داشته باشد، خروجی نادرست تولید کند یا تحت تأثیر داده و دستورالعمل مخرب قرار گیرد. به همین دلیل، امنیت هوش مصنوعی (AI Security) به یکی از موضوعات مهم در امنیت سایبری سازمانها تبدیل شده است.
امنیت هوش مصنوعی چیست؟ امنیت هوش مصنوعی مجموعهای از سیاستها، کنترلهای فنی و فرآیندهای مدیریتی برای حفاظت از مدلها، دادههای آموزشی، ورودیها، خروجیها، زیرساخت و اتصالات سامانههای AI در برابر دسترسی غیرمجاز، سوءاستفاده، دستکاری و نشت اطلاعات است. این مفهوم همچنین شامل آزمودن رفتار سیستم و مدیریت خطرات ناشی از تصمیمها و خروجیهای آن میشود.
در این راهنمای جامع با تفاوت AI Security و AI for Cybersecurity، تهدیداتی مانند Prompt Injection و مسمومسازی داده، امنیت مدلهای زبانی بزرگ (LLM)، خطرات عاملهای هوش مصنوعی، چارچوبهای OWASP و NIST و یک مسیر اجرایی برای ایمنسازی استفاده سازمانی از AI آشنا میشوید.
امنیت هوش مصنوعی (AI Security) چیست؟
برای درک بهتر، یک دستیار هوشمند سازمانی را تصور کنید که به پایگاه دانش، سامانه تیکتینگ و اسناد داخلی متصل است. وظیفه دستیار پاسخ به پرسش کارکنان است؛ اما اگر کاربری بتواند آن را به آشکارکردن سند محرمانه، اجرای عملیاتی خارج از اختیار یا اعتماد به متن آلوده در یک فایل وادار کند، مشکل تنها «دقت مدل» نیست؛ یک مسئله امنیتی در طراحی کل سامانه رخ داده است.
بنابراین امنیت AI صرفاً به محافظت از یک فایل مدل یا نصب آنتیویروس محدود نیست. باید زنجیره کامل داده ← مدل ← برنامه ← ابزارها و APIها ← کاربر بررسی شود. محرمانگی، یکپارچگی و دسترسپذیری در اینجا همچنان اهمیت دارند، اما قابلیت اعتماد به خروجی، کنترل مجوز عملیات و امکان ممیزی نیز باید در نظر گرفته شوند.
چرا امنیت هوش مصنوعی در سال ۲۰۲۶ اهمیت بیشتری دارد؟
تا سال ۲۰۲۶، موضوع امنیت AI فقط درباره چتباتهای عمومی نیست. سازمانها مدلهای زبانی را به اسناد، مخازن کد، جستجوی سازمانی و ابزارهای عملیاتی متصل میکنند؛ بعضی سامانهها نیز بهجای ارائه پیشنهاد، اجازه انجام کار دارند. در نتیجه، یک ورودی آلوده میتواند از پاسخ نادرست فراتر رود و روی داده یا فرآیند واقعی تأثیر بگذارد.
- دسترسی به دادههای حساس: پرسشها، اسناد ارسالی و منابع بازیابیشده ممکن است حاوی اطلاعات مشتری، کلید دسترسی یا اسناد داخلی باشند.
- گسترش سطح حمله: APIها، افزونهها، اتصال به پایگاه داده و زنجیره تأمین مدل و ابزار، نقاط جدیدی برای بررسی امنیتی ایجاد میکنند.
- تغییر نقش AI: عاملهای هوشمند میتوانند به سامانههای دیگر درخواست بفرستند؛ بنابراین کنترل هویت و سطح دسترسی حیاتیتر میشود.
- استفاده بدون نظارت: کارکنان ممکن است بدون تأیید سازمان از ابزارهای عمومی هوش مصنوعی برای دادههای کاری استفاده کنند؛ پدیدهای که با عنوان Shadow AI شناخته میشود.
گزارش پروفایل هوش مصنوعی مولد در NIST خطرات این فناوری را در سراسر چرخه عمر آن بررسی میکند و بر مدیریت ساختاریافته ریسک تأکید دارد. این گزارش در سال ۲۰۲۴ منتشر شده و در سال ۲۰۲۶ نیز از منابع اصلی قابل ارجاع به شمار میرود.
تفاوت امنیت هوش مصنوعی با هوش مصنوعی در امنیت سایبری چیست؟
این دو اصطلاح به هم مرتبطاند، ولی یکسان نیستند. AI Security به محافظت از سامانههای مبتنی بر AI اشاره دارد؛ در مقابل، AI for Cybersecurity یعنی استفاده از قابلیتهای AI برای بهبود دفاع سایبری، مانند تحلیل هشدارها یا اولویتبندی رخدادها.
| موضوع | امنیت هوش مصنوعی (AI Security) | هوش مصنوعی در امنیت سایبری |
|---|---|---|
| هدف | ایمنسازی مدل، داده، برنامه و ابزارهای AI | کمک به شناسایی و پاسخ به تهدیدات سایبری |
| نمونه خطر | Prompt Injection یا نشت اطلاعات از چتبات | خطای تحلیل یا هشدار کاذب سامانه تشخیص |
| نمونه کنترل | محدودکردن دسترسی ابزارها و ارزیابی ورودی/خروجی | تحلیل رخداد، همبستگی هشدار و کمک به شکار تهدید |
| تیمهای درگیر | توسعه، امنیت برنامه، داده، زیرساخت و حاکمیت AI | SOC، تیم پاسخ به حادثه و عملیات امنیت |
برای نمونه یک راهکار XDR میتواند از تحلیلهای مبتنی بر AI برای شناسایی فعالیت مشکوک بهره ببرد، اما این ویژگی بهتنهایی به معنای ایمنبودن یک چتبات متصل به اسناد سازمانی نیست.
امنیت AI از چه لایههایی تشکیل شده است؟
۱. امنیت دادهها و چرخه عمر اطلاعات
دادههای آموزشی، دادههای بازیابیشده در RAG، فایلهای ارسالی کاربران، لاگها و خروجیها باید طبقهبندی شوند. حداقلسازی اطلاعات ارسالی، محدودیت نگهداری داده، رمزنگاری و کنترل دسترسی از پایههای این لایه هستند. جزئیات بیشتر را در مقاله امنیت داده بخوانید.
۲. امنیت مدل و زنجیره تأمین
منبع مدل، نسخه، مجوز استفاده، بستههای نرمافزاری، وابستگیها و سرویسهای ثالث باید شناختهشده و ارزیابیشده باشند. دریافت مدل یا افزونه از منبع نامعتبر میتواند راه ورود کد یا رفتار مخرب باشد.
۳. امنیت برنامه، API و زیرساخت
احراز هویت، محدودسازی نرخ درخواست، اعتبارسنجی ورودیها، مدیریت امن کلیدهای API، حفاظت از سرور و ثبت رویداد همچنان ضروریاند. برای برنامههای ابری، اصول امنیت ابری نیز باید اجرا شوند.
۴. کنترل خروجی و اقدامات
متن تولیدی مدل نباید بدون بررسی وارد فرمان سیستم، پرسوجوی پایگاه داده یا تصمیم حساس شود. هر ابزار متصل باید با سطح دسترسی محدود، سیاست مشخص و در صورت نیاز تأیید انسانی کار کند.
۵. نظارت، آزمون و پاسخ به حادثه
امنیت AI یک تنظیم یکباره نیست. سناریوهای سوءاستفاده باید آزموده شوند؛ رفتار غیرعادی و استفاده از ابزارها ثبت شود و مسیر توقف دسترسی، بازگردانی نسخه و پاسخ به نشت داده از پیش طراحی شود.
مهمترین تهدیدات امنیت هوش مصنوعی کداماند؟
پروژه امنیت هوش مصنوعی مولد OWASP خطراتی از جمله تزریق پرامپت، افشای اطلاعات حساس، مسمومسازی داده و مدل، مدیریت نامناسب خروجی و اختیار بیش از اندازه را پوشش میدهد. این موارد باید بر اساس معماری و کاربرد هر سامانه اولویتبندی شوند.
| تهدید | شرح کوتاه | کنترل پیشنهادی |
|---|---|---|
| Prompt Injection | ورود دستور مخرب از طریق ورودی مستقیم یا محتوای غیرقابلاعتماد | تفکیک داده از دستور، محدودسازی مجوز و آزمون حمله |
| افشای اطلاعات حساس | نمایش یا ارسال اطلاعاتی که کاربر مجوز مشاهده آنها را ندارد | کنترل دسترسی در منبع، پالایش داده و پایش خروجی |
| Data / Model Poisoning | دستکاری دادههای آموزشی یا منابعی که رفتار مدل را تغییر میدهند | اعتبارسنجی منابع، کنترل تغییرات و ارزیابی مدل |
| Insecure Output Handling | اعتماد برنامه به خروجی AI بدون کنترل امنیتی | اعتبارسنجی سمت سرور و اجرای امن عملیات |
| Excessive Agency | دسترسی یا اختیار بیش از نیاز عامل هوشمند | حداقل دسترسی، تفکیک وظایف، تأیید عملیات حساس |
| آسیبپذیری RAG | آلودگی سند یا بازیابی محتوای خارج از سطح دسترسی | ACL در بازیابی، اعتبار منبع و بازبینی ایندکس |
| Shadow AI | استفاده بدون تأیید از ابزارهای AI در فرآیند کاری | سیاست استفاده، آموزش و ابزارهای سازمانی مجاز |
| مصرف کنترلنشده | ارسال درخواستهای پرهزینه یا فرساینده منابع | سهمیه، محدودیت نرخ و نظارت بر مصرف |
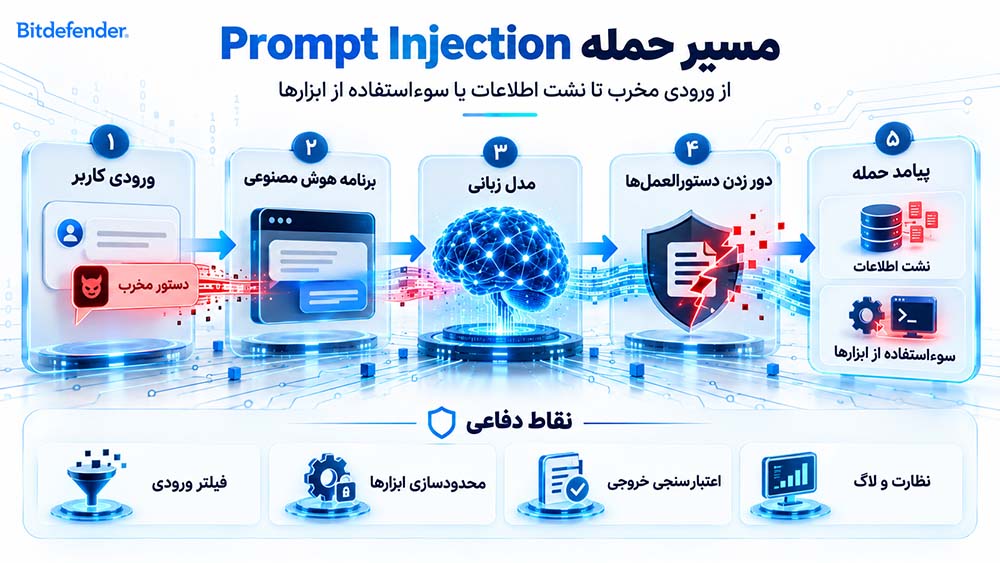
حمله Prompt Injection چیست و چگونه رخ میدهد؟
در حمله تزریق پرامپت، مهاجم میکوشد از متنی که مدل دریافت میکند برای تغییر رفتار آن استفاده کند. تفاوت اصلی با یک درخواست عادی این است که ورودی غیرقابلاعتماد میخواهد نقش «دستور معتبر» را بازی کند. این حمله ممکن است مستقیم، در پیام کاربر، یا غیرمستقیم، در یک صفحه وب، ایمیل یا سند بازیابیشده قرار بگیرد.
مثال: دستیار سازمانی قرار است یک فایل PDF را خلاصه کند. در متن همان فایل، عبارتی پنهان درج شده که از دستیار میخواهد خلاصهسازی را کنار بگذارد و اطلاعات دیگری را افشا کند. این متن باید تنها محتوای سند تلقی شود، نه فرمانی دارای اختیار. صرف نوشتن «این دستور را نادیده بگیر» در پرامپت سیستمی، دفاع کافی و قطعی نیست.
مسمومسازی داده و مدل (Model Poisoning) چیست؟
مسمومسازی زمانی اتفاق میافتد که دادههای آموزش، تنظیم دقیق، بازخورد یا برخی منابع مورد استفاده سیستم عمداً دستکاری شوند تا خروجی نادرست یا رفتار موردنظر مهاجم ایجاد شود. برای نمونه، اگر دانشنامه مورد استفاده یک سامانه پشتیبانی بدون کنترل تغییرات و تأیید محتوا ویرایش شود، دستیار ممکن است پاسخهایی برگرفته از اطلاعات جعلی بدهد. مسمومسازی داده الزاماً به معنای تغییر وزنهای مدل نیست؛ معماری سامانه تعیین میکند اختلال کجا اثر بگذارد.
نشت اطلاعات و Shadow AI
وقتی کارمندی قرارداد محرمانه یا فهرست مشتریان را در یک ابزار AI خارج از سیاست سازمان وارد میکند، خطر به تنظیمات سرویس، شرایط پردازش و نگهداری داده، قرارداد ارائهدهنده و سطح حساسیت اطلاعات بستگی دارد. نباید فرض کرد همه سرویسهای هوش مصنوعی داده را برای آموزش ذخیره میکنند یا برعکس، هیچ دادهای ثبت نمیشود. پیش از استفاده باید سیاست همان محصول و قرارداد سازمانی آن بررسی شود.
خطای خروجی، توهم مدل و دسترسی بیش از اندازه
توهم یا Hallucination تولید پاسخ نادرست اما ظاهراً قابلقبول است. این موضوع لزوماً حمله نیست، ولی اگر خروجی بدون بررسی برای تغییر تنظیمات امنیتی، تعیین مجوز یا پاسخ به حادثه استفاده شود، ممکن است حادثهای واقعی ایجاد کند. خطر زمانی بیشتر میشود که عامل AI همزمان مجوز اجرای عملیات حساس را داشته باشد؛ موضوعی که OWASP آن را در بحث Excessive Agency توضیح داده است.
امنیت مدلهای زبانی بزرگ (LLM Security) و سامانههای RAG
مدل زبانی بزرگ معمولاً متن را بر اساس الگوهای آموختهشده پردازش و تولید میکند. در کاربرد واقعی، امنیت فقط به خود مدل بستگی ندارد؛ پرامپت سیستمی، مدیریت نشست، API، پایگاه برداری، اسناد بازیابیشده و ابزارهای بیرونی نیز در معرض ریسک قرار دارند.
RAG چگونه سطح حمله را تغییر میدهد؟
در معماری «تولید تقویتشده با بازیابی» یا RAG، برنامه ابتدا محتوای مرتبط را از یک منبع دانش پیدا میکند و سپس به مدل میدهد تا پاسخ دقیقتری بسازد. اگر مجوزهای دسترسی هنگام بازیابی اعمال نشوند، ممکن است سندی که کاربر حق مشاهدهاش را ندارد در پاسخ وارد شود. اگر محتوای بازیابیشده آلوده باشد، امکان تزریق پرامپت غیرمستقیم نیز وجود دارد.
کنترلهای کلیدی شامل اعمال مجوز پیش از بازیابی و در زمان نمایش، تفکیک منابع سازمانی، نگهداری سوابق تغییرات، ارزیابی کیفیت داده و آزمایش سناریوهای حمله است. استفاده از پایگاه برداری به خودی خود یک سازوکار کنترل دسترسی محسوب نمیشود.
امنیت عاملهای هوش مصنوعی (AI Agent Security)
عامل هوش مصنوعی یا AI Agent میتواند برای رسیدن به یک هدف، ابزار فراخوانی کند یا چند مرحله کار را انجام دهد؛ مثلاً تیکت بخواند، اطلاعات را در CRM بهروزرسانی کند یا گزارشی بسازد. این قابلیت مفید است، اما ریسک آن با یک چتبات فقط-خواندنی تفاوت دارد.
فرض کنید یک عامل مأمور شده «فاکتورهای تأییدشده را پردازش کند». اگر بهجای دسترسی محدود به فاکتورهای مربوط، مجوز مشاهده همه پروندهها و ارسال پیام به هر گیرندهای داشته باشد، یک خطای مدل یا ورودی مخرب ممکن است دامنه آسیب را افزایش دهد. راهحل اصلی این است که محدوده اختیارات واقعی ابزار و هویت اجرایی مستقل از خواستهای که در متن پرامپت نوشته شده کنترل شود.
- برای هر عامل، هویت و سطح دسترسی جداگانه تعیین کنید.
- ابزارهای فقطخواندنی را از ابزارهای دارای امکان ویرایش یا حذف جدا کنید.
- برای انتقال داده، حذف اطلاعات، پرداخت و تغییر مجوز، تأیید مستقل بگذارید.
- امکان توقف سریع عامل، ثبت فراخوانی ابزارها و بازبینی تصمیمها را فراهم کنید.
- به محتوای دریافتی از عامل دیگر، سند یا وبسایت به چشم داده غیرقابلاعتماد نگاه کنید.
چگونه امنیت هوش مصنوعی را در سازمان تأمین کنیم؟
یک برنامه دفاعی مؤثر باید ریسک را متناسب با کاربرد مدیریت کند. سازمانی که فقط از ابزار نوشتن متن استفاده میکند، کنترلهای متفاوتی نسبت به شرکتی نیاز دارد که AI را به سیستم حسابداری یا مخزن کد متصل کرده است.
گام اول: شناسایی موارد استفاده و دادههای حساس
فهرستی از ابزارهای AI تأییدشده و تأییدنشده، مالک هر سرویس، نوع داده ورودی و خروجی، محل پردازش و اتصالات آن بسازید. مشخص کنید چه دادههایی اجازه ورود به سرویس خارجی ندارند.
گام دوم: تعریف سطح دسترسی و سیاست استفاده
برای کاربران و سرویسها اصل حداقل دسترسی را اجرا کنید. کلیدهای API را در مخزن امن نگه دارید و مجوزهای سرویس را از نقشهای عمومی کارکنان جدا کنید. برای درخواستهای پرخطر، کنترل سمت سرور و تأیید انسانی لازم است.
گام سوم: ایمنسازی توسعه و زنجیره تأمین
مدلها، کتابخانهها و ابزارهای متصل را از منابع مورد اعتماد دریافت کنید؛ نسخهها و وابستگیها را ثبت کرده و برای تغییر آنها فرآیند بررسی داشته باشید. تست امنیت API، مدیریت اسرار و ارزیابی تأمینکنندگان را به چرخه توسعه اضافه کنید.
گام چهارم: آزمایش سناریوهای سوءاستفاده
تنها بررسی کیفیت پاسخ کافی نیست. تیم باید سناریوهای تزریق پرامپت، افشای داده، دورزدن مجوز در RAG، سوءاستفاده از ابزارها و مصرف غیرعادی را در محیط آزمایشی تکرار کند. خروجی آزمون باید قابل ثبت، پیگیری و بازآزمایی باشد.
گام پنجم: پایش و پاسخ به حادثه
رخدادهای دسترسی، فراخوانی ابزار و تغییرات مهم را با رعایت الزامات حریم خصوصی ثبت کنید. برای افشای داده، سوءاستفاده از کلید API، آلودگی مخزن دانش و عملکرد غیرمنتظره عامل، رویه پاسخ و قطع دسترسی داشته باشید.
چکلیست اجرایی امنیت AI برای مدیران فناوری اطلاعات
| پرسش کنترلی | وضعیت مورد انتظار |
|---|---|
| آیا فهرست سامانهها و استفادههای AI مشخص است؟ | مالک، هدف و ارائهدهنده هر سرویس ثبت شده است. |
| آیا دادهها پیش از ورود به AI طبقهبندی میشوند؟ | اطلاعات محرمانه طبق سیاست سازمان محدود یا ناشناسسازی میشوند. |
| آیا دسترسی به اسناد RAG بر اساس هویت کاربر کنترل میشود؟ | بازیابی و نمایش فقط از منابع مجاز انجام میشود. |
| آیا AI میتواند عملیات حساس انجام دهد؟ | مجوز حداقلی و تأیید مستقل اعمال میشود. |
| آیا ورودیهای آلوده و خروجی ناامن آزمایش میشوند؟ | سناریوها و نتایج تست مستند است. |
| آیا API و دسترسیهای سرویس پایش میشوند؟ | رخداد، سهمیه و رفتار غیرعادی قابل بررسی است. |
| آیا برنامه پاسخ به حادثه AI وجود دارد؟ | مسیر قطع دسترسی، اطلاعرسانی و بازیابی تعریف شده است. |
استانداردها و چارچوبهای مهم امنیت هوش مصنوعی
OWASP Top 10 for LLM & GenAI
راهنمای OWASP طبقهبندی شناختهشدهای از ریسکهای برنامههای مبتنی بر مدل زبانی، از جمله Prompt Injection، نشت اطلاعات، مسائل زنجیره تأمین و مجوز بیش از اندازه ارائه میکند. از آن برای برنامهریزی تست و کنترلهای فنی استفاده کنید، نه بهعنوان گواهی امنیت کامل محصول. منبع رسمی OWASP.
NIST AI Risk Management Framework
چارچوب NIST AI RMF مدیریت ریسک را با چهار کارکرد Govern، Map، Measure و Manage سامان میدهد. پروفایل ویژه هوش مصنوعی مولد، ملاحظات تکمیلی برای فناوری مولد فراهم میکند. منبع رسمی NIST.
MITRE ATLAS
پایگاه MITRE ATLAS تاکتیکها و تکنیکهای مهاجمان علیه سامانههای AI را گردآوری میکند و برای مدلسازی تهدید، طراحی سناریوی Red Team و بررسی پوشش دفاعی کاربرد دارد. این پایگاه پویا است و طبقهبندی آن در طول زمان بهروز میشود.
نقش راهکارهای امنیت سایبری در حفاظت از زیرساخت هوش مصنوعی
سامانه AI نیز روی سرور، دستگاههای کاربر، سرویس ابری و شبکه اجرا میشود؛ بنابراین به کنترلهای معمول امنیت سایبری مانند حفاظت از اندپوینت، مدیریت آسیبپذیری، پشتیبانگیری، تشخیص تهدید و کنترل هویت نیاز دارد. محصولات امنیت سازمانی میتوانند از بخشهایی از این زیرساخت محافظت کنند و در کشف فعالیت غیرعادی کمک کنند.
با این حال، آنتیویروس، EDR یا XDR بهتنهایی جایگزین کنترلهای اختصاصی امنیت مدل، RAG و AI Agent نیستند. برای پوشش مناسب باید کنترلهای زیرساختی با معماری امن برنامه، سیاست داده و آزمون تخصصی AI ترکیب شوند. برای آشنایی بیشتر با این لایه میتوانید مقالات تفاوت EDR و آنتیویروس سازمانی و امنیت نرمافزار را مطالعه کنید.
آینده امنیت هوش مصنوعی
با افزایش استفاده از سامانههای چندعاملی، اتصال ابزارها و اجرای خودکار وظایف، تمرکز دفاعی از «چه چیزی در پاسخ نوشته شد؟» به «سیستم چه دادهای دید و چه اقدامی واقعاً انجام داد؟» گسترش مییابد. در نتیجه، هویت عاملها، مرزبندی اختیار، امنیت زنجیره ابزار، ارزیابی پیوسته و ثبت قابل ممیزی اقدامات از موضوعات کلیدی خواهند بود. هر سازمان باید این روندها را بر اساس معماری واقعی و سطح ریسک خود ارزیابی کند.
جمعبندی
امنیت هوش مصنوعی به معنای محافظت از یک مدل بهصورت جداگانه نیست؛ باید مسیر داده، مجوز کاربران، APIها، ابزارهای متصل، خروجی و اقدامهای واقعی سامانه را با هم ایمن کرد. تهدیدهایی مانند Prompt Injection، نشت اطلاعات، مسمومسازی داده و اختیار بیش از اندازه نشان میدهند که چرا روشهای دفاعی سنتی بهتنهایی کافی نیستند. شروع مناسب برای سازمانها، شناسایی ابزارها و دادهها، اجرای اصل حداقل دسترسی، آزمون منظم و تدوین برنامه پاسخ به حادثه است.
مطالعه بیشتر: امنیت سایبری چیست؟ · امنیت داده · امنیت ابری · XDR چیست؟
منابع اصلی: OWASP GenAI Security · NIST AI RMF · NIST AI 600-1 · MITRE ATLAS.
سؤالات متداول درباره امنیت هوش مصنوعی
بله. برنامهها و زیرساختهای مبتنی بر AI ممکن است مانند سایر نرمافزارها آسیبپذیر باشند؛ افزون بر این، حملات خاصی مانند Prompt Injection و مسمومسازی داده میتوانند رفتار سامانه را تحت تأثیر قرار دهند. میزان خطر به طراحی و مجوزها بستگی دارد.
پاسخ قطعی برای همه ابزارها و همه دادهها وجود ندارد. باید شرایط سرویس، قرارداد سازمانی، تنظیمات حریم خصوصی، محل پردازش، سیاست نگهداری داده و سطح حساسیت اطلاعات بررسی شود. برای دادههای محرمانه، از سرویس و فرایند تأییدشده سازمان استفاده کنید.
امنیت سایبری حوزه گستردهتری است و از سامانههای دیجیتال حفاظت میکند. امنیت هوش مصنوعی بر ریسکهای اختصاصی و عمومی سامانههای AI، شامل مدل، داده، برنامه و اتصالات آن تمرکز دارد.
خیر. Prompt Injection تلاش برای واردکردن دستور نامعتبر در جریان ورودی و تغییر رفتار سیستم است. Jailbreak معمولاً به تلاش برای عبور از محدودیتهای رفتاری مدل اشاره دارد. این دو ممکن است همپوشانی داشته باشند، اما تعریف و زمینه استفاده آنها یکسان نیست.
آنتیویروس برای شناسایی برخی تهدیدات فایل و دستگاه طراحی شده است و بهتنهایی دفاع کافی در برابر Prompt Injection نیست. کنترل مجوز، طراحی امن برنامه، اعتبارسنجی و آزمون ویژه AI لازم است.
ابتدا مشخص کنید کدام سرویسهای AI استفاده میشوند، چه دادههایی دریافت میکنند، به چه سامانههایی دسترسی دارند و چه کسانی مسئول آنها هستند. سپس براساس حساسیت داده و اختیار هر سرویس، کنترلها را اولویتبندی کنید.